dbt : passer du dataset Small au dataset Large
Remplacez le dataset Small par 340 jeux, rejouez toute la chaîne dbt et vérifiez que vos modèles et vos tests tiennent sans réécrire le SQL.

Découvrir dbt avec un projet simple
- Installer dbt et créer nos premières tables
- Construire nos premiers modèles Silver
- Tester la qualité de nos données
- Construire notre première zone Gold
- Passer du dataset Small au dataset Large Vous êtes ici
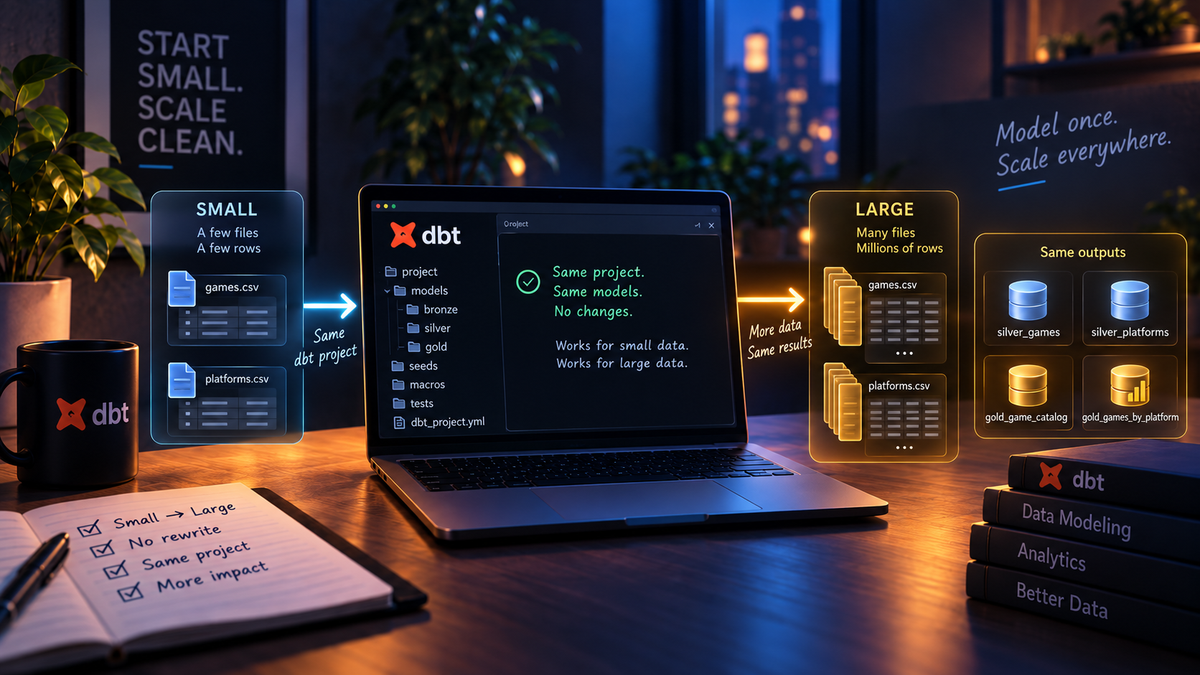
Nous avons construit toute notre chaîne avec 20 jeux et 3 plateformes. Les seeds alimentent les modèles Silver, les modèles Silver alimentent le catalogue Gold et nos tests vérifient quelques règles de qualité.
Nous allons maintenant remplacer games.csv par la version Large du dataset. Elle contient 340 jeux répartis sur les mêmes trois plateformes.
Le but n'est pas de mesurer les performances de DuckDB. Même la version Large reste minuscule pour une base analytique. Nous voulons vérifier une idée plus importante : une transformation bien décrite doit continuer à fonctionner lorsque le volume et le contenu des données changent.
Vérifier une dernière fois la version Small
Revenons dans le projet et activons l'environnement Python :
Set-Location "$env:USERPROFILE\Documents\dbt-retro-games"
.venv\Scripts\Activate.ps1
Reconstruisons l'ensemble du projet :
dbt buildPuis comptons les lignes du catalogue Gold :
dbt show --inline "select count(*) as game_count from {{ ref('gold_game_catalog') }}"Le résultat doit être égal à 20.
Affichons également le résumé par plateforme :
dbt show --select gold_games_by_platformNous obtenons 7 jeux pour la NES, 7 pour la Master System et 6 pour la Super Nintendo.
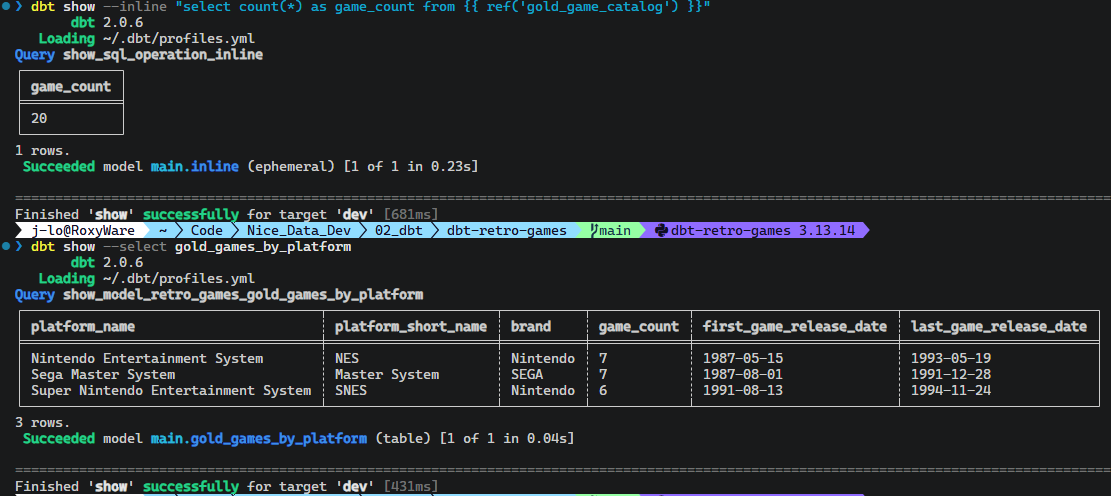
Nous avons maintenant notre point de comparaison. Passons à la version Large.
Télécharger la version Large
Nous allons remplacer les deux CSV présents dans seeds. Les fichiers Small resteront disponibles dans le dépôt public Nice Data si nous voulons revenir en arrière plus tard.
Toujours depuis la racine du projet, exécutons :
$baseUrl = "https://raw.githubusercontent.com/nicedatafr/datasets/retro-video-games-v1.0.0/retro-video-games/data/v1/large/relational/csv"

Invoke-WebRequest -Uri "$baseUrl/games.csv" -OutFile "seeds/games.csv"
Invoke-WebRequest -Uri "$baseUrl/platforms.csv" -OutFile "seeds/platforms.csv"
Les noms de fichiers n'ont pas changé. Pour dbt, il s'agit toujours des ressources games et platforms, mais leur contenu est maintenant celui de la version Large.
Recharger complètement les seeds
Nous ne voulons pas ajouter quelques lignes à nos tables existantes. Nous voulons remplacer leur contenu par celui des nouveaux fichiers.
Demandons donc à dbt de recréer les tables :
dbt seed --full-refreshL'option --full-refresh indique explicitement que les tables doivent être reconstruites à partir des CSV actuels.
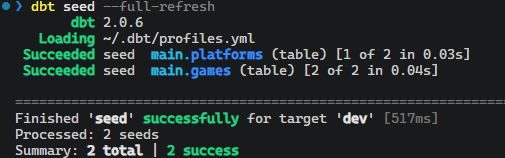
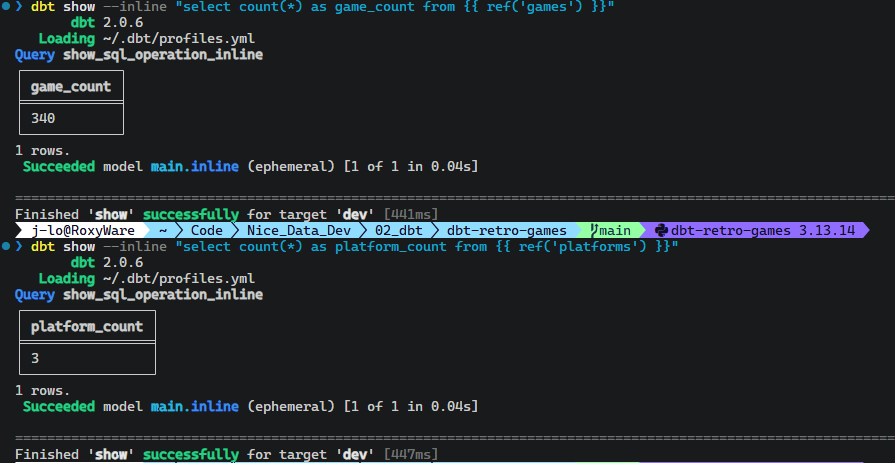
Vérifions le nombre de lignes chargées :
dbt show --inline "select count(*) as game_count from {{ ref('games') }}"
dbt show --inline "select count(*) as platform_count from {{ ref('platforms') }}"
Nous devons maintenant obtenir 340 jeux et toujours 3 plateformes.
Reconstruire Silver et Gold
Nous n'allons modifier aucun modèle SQL. Lançons simplement :
dbt builddbt reconstruit les modèles Silver, les deux modèles Gold et exécute les tests associés.
Si toute la chaîne réussit, la logique écrite pour 20 jeux fonctionne maintenant sur 340 lignes.
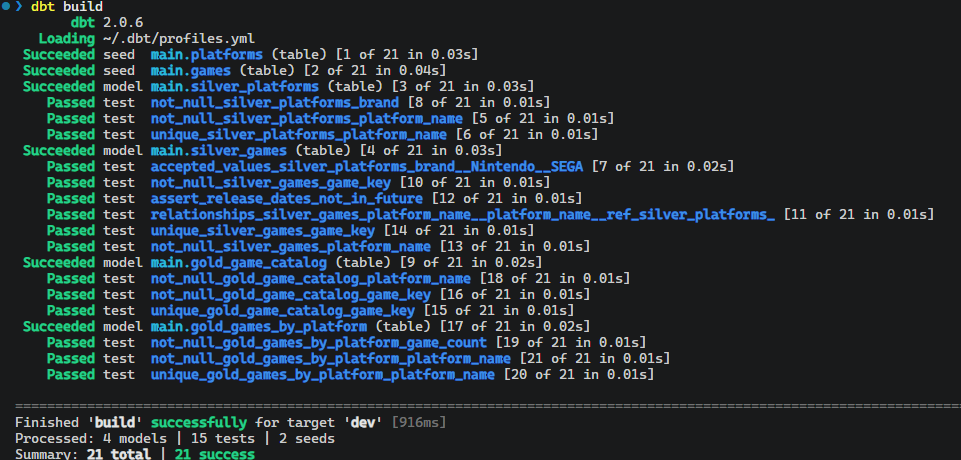
Comptons les jeux du catalogue :
dbt show --inline "select count(*) as game_count from {{ ref('gold_game_catalog') }}"Le résultat doit être égal à 340.
Affichons ensuite le résumé :
dbt show --select gold_games_by_platformNous devons retrouver les volumes suivants :
Nintendo Entertainment System         66
Sega Master System                    120
Super Nintendo Entertainment System  154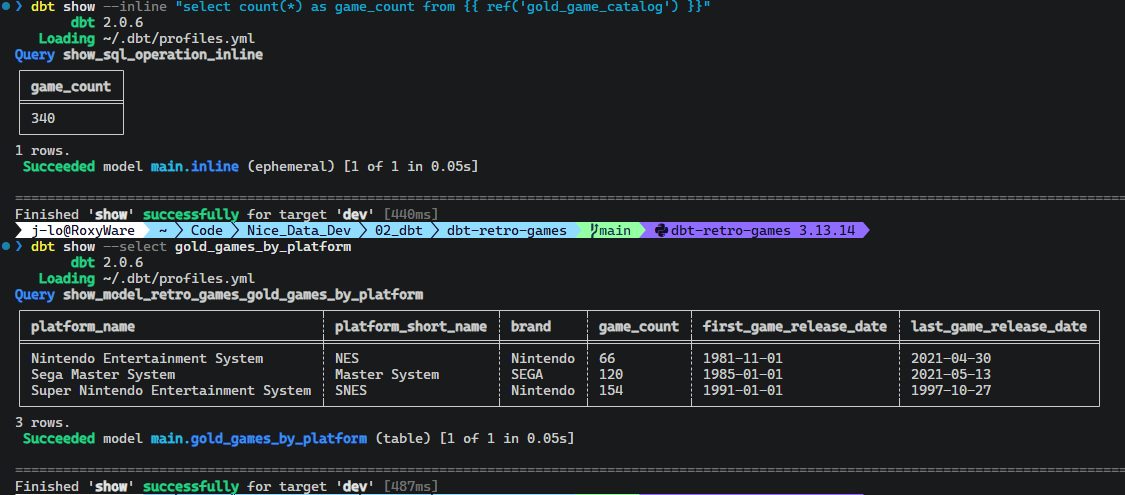
Une clé qui devient réellement utile
Dans le deuxième article, nous avons construit game_key avec le nom du jeu et sa plateforme :
concat_ws(' | ', official_name, platform_official_name)Avec le dataset Small, chaque nom de jeu était déjà unique. Nous aurions pu croire que la plateforme était inutile dans cette clé.
La version Large contient plusieurs titres présents sur différentes plateformes. Vérifions-le :
dbt show --inline "select game_name, count(*) as line_count from {{ ref('silver_games') }} group by game_name having count(*) > 1 order by game_name"La requête renvoie plusieurs noms. Un test unique aurait donc échoué si nous l'avions placé sur game_name seul.
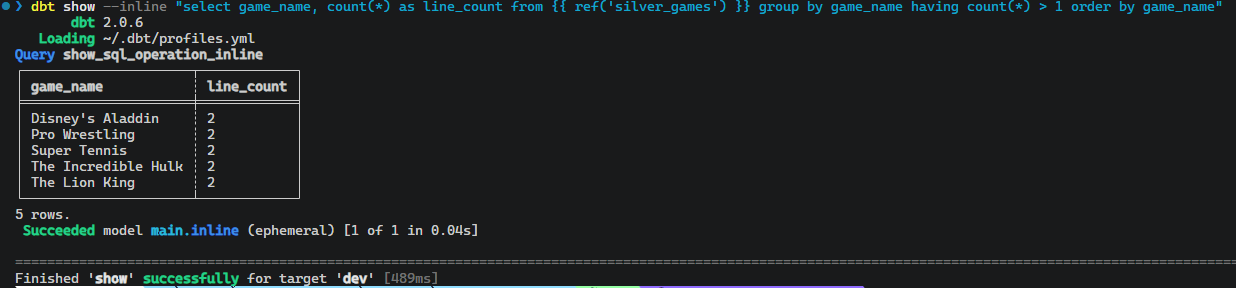
game_key, en revanche, reste unique parce que cette colonne représente mieux la granularité de notre table : un jeu sur une plateforme.
Cet exemple montre pourquoi un test n'est pas seulement une vérification technique. Il nous oblige à préciser ce qu'une ligne représente réellement.
Revenir à Small si nécessaire
Pour restaurer la version Small, il suffit de télécharger à nouveau ses fichiers puis de reconstruire le projet :
$baseUrl = "https://raw.githubusercontent.com/nicedatafr/datasets/retro-video-games-v1.0.0/retro-video-games/data/v1/small/relational/csv"

Invoke-WebRequest -Uri "$baseUrl/games.csv" -OutFile "seeds/games.csv"
Invoke-WebRequest -Uri "$baseUrl/platforms.csv" -OutFile "seeds/platforms.csv"

dbt seed --full-refresh
dbt build
Nous conserverons toutefois la version Large pour la suite.
Pourquoi ne pas continuer avec des seeds en production ?
Notre démonstration fonctionne très bien : dbt seed charge 340 lignes sans difficulté. Ce résultat ne change pas le rôle initial des seeds.
Dans une vraie chaîne de données, nous ne remplacerions généralement pas un CSV dans le projet à chaque nouvelle livraison. Un processus d'ingestion récupérerait les données, conserverait leur historique si nécessaire et créerait les tables sources attendues.
dbt prendrait ensuite le relais pour transformer ces tables vers Silver et Gold.
La différence peut se résumer ainsi :
Notre apprentissage
CSV → dbt seed → Silver → Gold

Une chaîne plus réaliste
Source → ingestion → tables Bronze → dbt Silver → dbt Gold
Les seeds nous ont évité de construire la partie ingestion. Ils ne prétendent pas la remplacer.
En résumé
Notre projet dbt est maintenant complet : nous savons charger nos données de départ, construire les couches Silver et Gold, tester nos modèles et rejouer toute la chaîne sur un jeu de données plus important.
Pour rester concentrés sur dbt, nous avons volontairement utilisé les seeds comme point d'entrée de notre projet. Dans une architecture plus réaliste, les données seraient d'abord ingérées dans une véritable zone Bronze, puis dbt prendrait le relais pour les transformer.
Nous reviendrons peut-être sur ce projet plus tard pour franchir cette étape et l'intégrer dans une chaîne Data plus complète.
Ressources officielles
- Approfondir le fonctionnement des seeds — comprendre
--full-refreshet les limites des seeds pour les données de production. - Comprendre la commande dbt build — rejouer et valider toute la chaîne de dépendances.