dbt : tester la qualité de nos données
Ajoutez des tests dbt à vos modèles Silver, provoquez un échec contrôlé et écrivez un test SQL personnalisé pour fiabiliser la qualité des données.

Découvrir dbt avec un projet simple
- Installer dbt et créer nos premières tables
- Construire nos premiers modèles Silver
- Tester la qualité de nos données Vous êtes ici
- Construire notre première zone Gold
- Passer du dataset Small au dataset Large
Dans le précédent article, nous avons créé silver_games et silver_platforms. Nous avons affiché quelques lignes et le résultat semblait cohérent.
Le vrai sujet ici est « semblait » cohérent. Regarder cinq lignes nous permet de voir que globalement, ça ressemble à ce qu'on attend mais ça ne nous garantit pas que toutes les clés sont renseignées, que chaque plateforme existe ou que deux lignes ne portent pas le même identifiant.
Dans de nombreux projets précédents, j'écrivais de très nombreuses requêtes SQL de test avec des COUNT(1) […] WHERE IS NULL par exemple.
dbt permet d'associer des tests à nos modèles. On va pouvoir intégrer dans notre développement toutes les règles que l'on veut tester. Pour notre projet, nous allons commencer avec quelques règles simples, provoquer volontairement une erreur, puis ajouter un test SQL écrit par nos soins.
Préparer l'environnement
Revenons dans le projet et activons son environnement Python si nécessaire :
Set-Location "$env:USERPROFILE\Documents\dbt-retro-games"
.venv\Scripts\Activate.ps1
Reconstruisons les modèles Silver afin de repartir d’un état connu :
dbt run --select path:models/silverDécrire nos modèles et définir leurs règles
Les tests génériques de dbt sont déclarés dans des fichiers YAML qui complètent nos modèles SQL avec leurs propriétés : descriptions, informations sur les colonnes, tests et autres métadonnées.
Le nom du fichier n'est pas imposé par dbt. Nous pourrions l'appeler autrement, mais nous allons utiliser silver.yml puisqu'il décrit les modèles présents dans notre dossier silver. Dans models/silver, créons silver.yml avec ce premier contenu :
version: 2

models:
  - name: silver_games
    description: Jeux vidéo préparés pour les analyses.
    columns:
      - name: game_key
        description: Identifiant composé du jeu et de sa plateforme.
        data_tests:
          - not_null
          - unique

      - name: platform_name
        description: Nom officiel de la plateforme du jeu.
        data_tests:
          - not_null
          - relationships:
              arguments:
                to: ref('silver_platforms')
                field: platform_name

  - name: silver_platforms
    description: Plateformes préparées pour les analyses.
    columns:
      - name: platform_name
        description: Nom officiel de la plateforme.
        data_tests:
          - not_null
          - unique

      - name: brand
        description: Marque de la plateforme.
        data_tests:
          - not_null
De façon plutôt lisible par un humain, nous venons d'exprimer plusieurs attentes :
game_keydoit toujours être renseignée et ne doit pas apparaître deux fois ;- chaque jeu doit avoir une plateforme ;
- cette plateforme doit exister dans
silver_platforms; - chaque nom de plateforme doit être renseigné et unique ;
- chaque plateforme doit avoir une marque.
Le test relationships correspond à une vérification de clé étrangère. Il recherche les valeurs de silver_games.platform_name absentes de silver_platforms.platform_name.
Lancer les tests
Exécutons maintenant :
dbt testdbt lance une requête pour chaque règle déclarée dans le fichier. Avec le dataset Small, tous les tests doivent réussir.
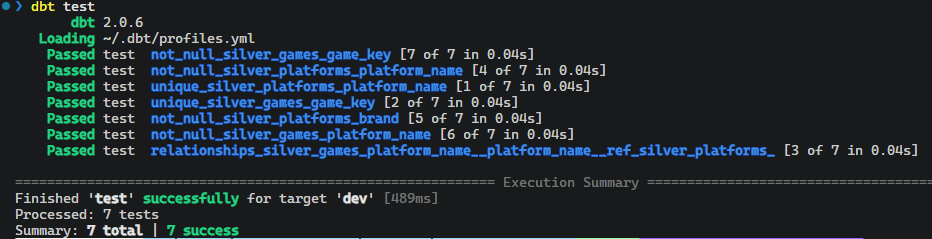
Une réussite ne signifie pas que dbt a lu le fichier et trouvé le mot unique dans la définition de la table. dbt a réellement interrogé nos tables pour rechercher les lignes qui ne respectent pas la règle.
Provoquer volontairement un échec
Un test est plus facile à comprendre lorsqu'on le voit échouer. Nous savons que notre table contient des plateformes de marques Nintendo et SEGA. Ajoutons temporairement un test qui affirme que toutes les marques doivent être Nintendo.
Dans la définition de la colonne brand, ajoutons accepted_values :
      - name: brand
        description: Marque de la plateforme.
        data_tests:
          - not_null
          - accepted_values:
              arguments:
                values: ['Nintendo']
Relançons uniquement les tests associés à silver_platforms :
dbt test --select silver_platformsCette fois, le test accepted_values doit échouer. Les lignes SEGA ne font pas partie de la liste autorisée.
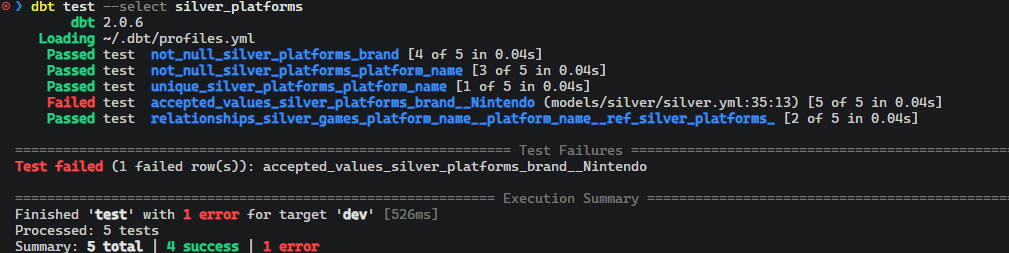
Cette erreur est volontaire. dbt a regardé chaque ligne et a regardé si la règle décrite était respectée. Aucune correction, aucune décision d'exclusion. On compare nos lignes et s'il y a ne serait-ce qu'une ligne qui ne la respecte pas, dbt remonte une erreur.
Corrigeons maintenant la liste pour ajouter la marque SEGA :
      - name: brand
        description: Marque de la plateforme.
        data_tests:
          - not_null
          - accepted_values:
              arguments:
                values: ['Nintendo', 'SEGA']
Puis relançons :
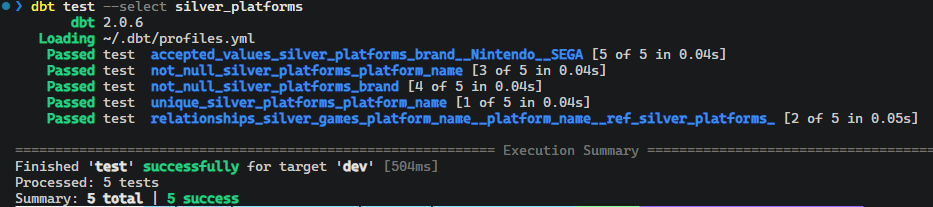
dbt test --select silver_platformsLe test doit maintenant réussir.
Ajouter un test SQL personnalisé
Les tests génériques couvrent de nombreux besoins classiques. Mais nous avons souvent besoin d'écrire un test spécifique. dbt nous permet d'écrire une requête SQL de test qui représente une anomalie.
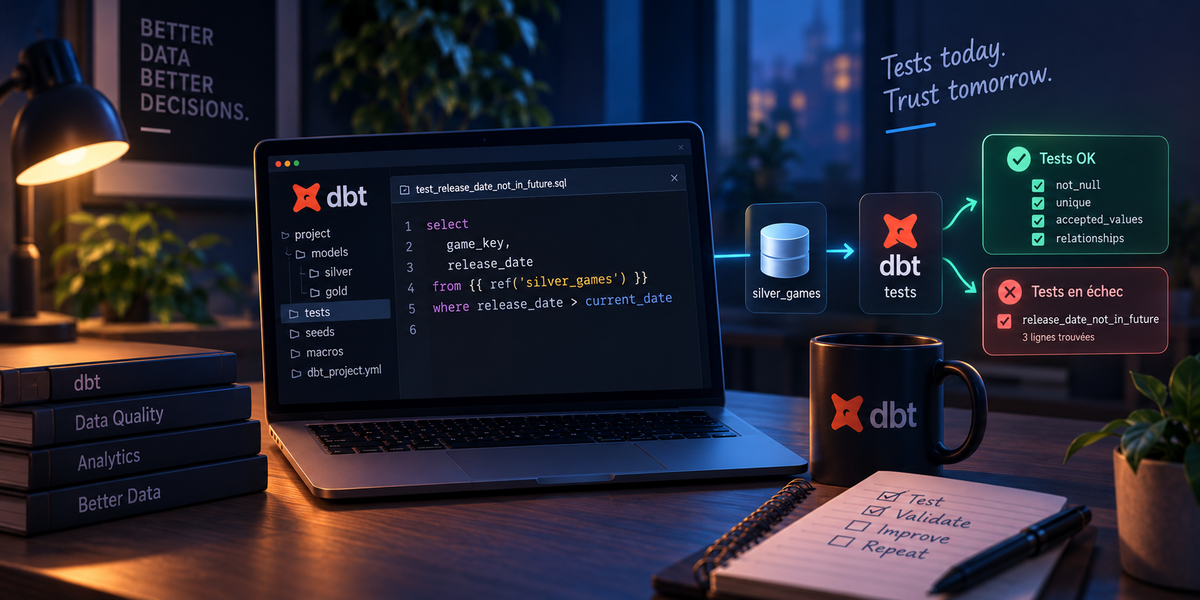
Créons le fichier tests/assert_release_dates_not_in_future.sql :
select
    game_key,
    release_date
from {{ ref('silver_games') }}
where release_date > current_date
Un test SQL dbt doit retourner les lignes en erreur. En gros, il faut concevoir sa requête pour que les lignes retrouvées par celle-ci soient des erreurs. Ici, la requête recherche les jeux dont la date de sortie se trouve dans le futur.
Si la requête ne renvoie aucune ligne, le test réussit. Si elle en renvoie une ou plusieurs, dbt considère que le test échoue et indique le nombre d'anomalies trouvées.
Lançons uniquement ce test :
dbt test --select assert_release_dates_not_in_future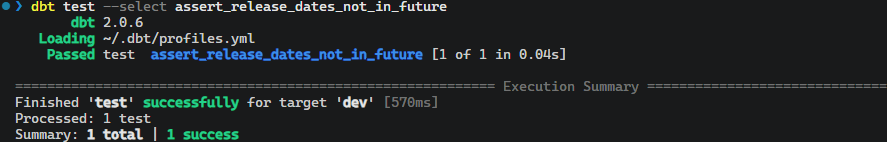
dbt run, dbt test, dbt build - Construire puis tester avec une seule commande
Depuis le début de la série, nous avons déjà utilisé plusieurs commandes dbt qui ont des rôles différents.
dbt run exécute les modèles. Dans notre projet, cela construit notamment silver_games et silver_platforms.
dbt test exécute les tests associés aux ressources. Cette commande ne reconstruit pas les modèles. Elle vérifie les données déjà présentes dans la base à partir des règles que nous avons définies.
Enfin, dbt build combine plusieurs étapes. Dans notre projet actuel, dbt exécute les ressources dans l’ordre de leurs dépendances : il charge les seeds, construit les modèles puis lance les tests associés.
On peut résumer ainsi :
dbt run    → construire les modèles
dbt test   → vérifier les données
dbt build  → construire puis vérifier l'ensemble du projet
Nous continuerons parfois à utiliser run et test séparément pour bien voir ce qui se passe à chaque étape. build devient particulièrement pratique lorsqu’on veut valider toute la chaîne en une seule commande.
Exécutons donc :
dbt build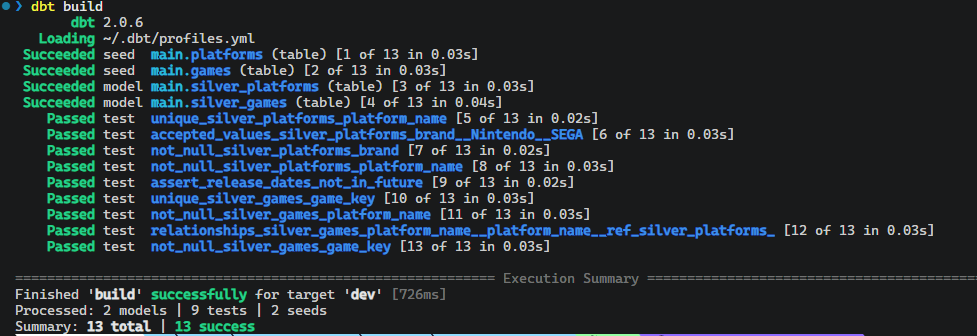
Les tests ne remplacent pas la réflexion
Nous aurions pu ajouter un grand nombre de règles simplement parce qu'elles existent. Ce n'est pas notre objectif.
Un bon test décrit une attente réelle sur les données. game_key doit être unique parce que nous voulons identifier une ligne. La relation vers les plateformes doit être valide parce que notre future jointure Gold en dépend. Les dates futures sont refusées parce que notre dataset décrit des jeux déjà sortis.
À l'inverse, tester une colonne sans savoir pourquoi elle devrait être unique peut créer une fausse alerte. Nous le verrons avec la version Large du dataset : le nom d'un jeu, pris seul, ne suffit pas toujours à identifier une ligne et l'assertion que le nom doit être unique est peut-être juste dans notre jeu de données actuel mais fausse au sens de la colonne.
Un des pièges dans l'écriture des tests est de vouloir en écrire trop ou de mal les cibler. Le testing est un vrai métier et il peut s'avérer dangereux s'il est mal compris.
En résumé
Nous avons déclaré des tests not_null, unique, relationships et accepted_values. Nous avons vu un test échouer, corrigé sa règle et ajouté une vérification écrite en SQL.
Nos modèles Silver ne sont donc plus seulement des tables qui semblent correctes. Ils portent maintenant une partie des attentes que nous avons sur leurs données.
Dans le prochain article, nous allons utiliser ces modèles contrôlés pour construire une première zone Gold : un catalogue de jeux enrichi et un résumé par plateforme.
Ressources officielles
- Ajouter des data tests à un projet dbt — découvrir les tests génériques et les tests SQL personnalisés.
- Comprendre la commande dbt build — construire les ressources et exécuter les tests selon leurs dépendances.