Data Engineering
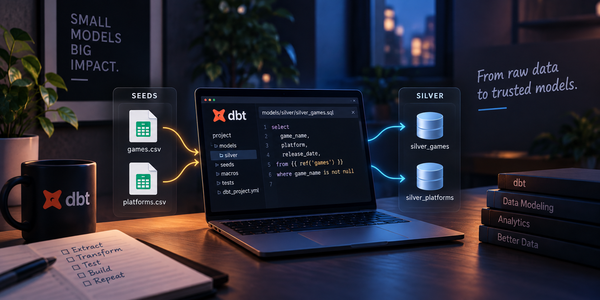
dbt : construire nos premiers modèles Silver
Construisez vos premiers modèles Silver avec dbt et DuckDB, découvrez ref(), les dépendances et les matérialisations, puis interrogez le résultat en SQL.
Data Engineering
Construisez vos premiers modèles Silver avec dbt et DuckDB, découvrez ref(), les dépendances et les matérialisations, puis interrogez le résultat en SQL.
Synapse nous permet d'utiliser Apache Spark en tant que Runtime de processing afin de travailler nos différents datasets. Dans cet article, nous allons créer notre premier notebook Spark (et le pool Spark nécessaire) pour transformer nos premières données de la zone bronze pour commencer à alimenter notre zone
Nous allons dans cette article "installer" la base d'exemple Wide Word Importer de Microsoft, la préparer et l'inspecter un minimum pour pouvoir débuter nos travaux de Datalake.
Afin d'optimiser des les requêtes effectués sur des fichiers parquets depuis un pool serverless, on travail généralement avec des dataset partitionné. Cette article décrit comment générer un dataset partitionné via un data flow Azure Synapse Analystics.