dbt : construire notre première zone Gold
Construisez deux modèles Gold avec dbt, reliez-les aux modèles Silver avec ref(), ajoutez des tests et visualisez le graphe de dépendances du projet.

Découvrir dbt avec un projet simple
- Installer dbt et créer nos premières tables
- Construire nos premiers modèles Silver
- Tester la qualité de nos données
- Construire notre première zone Gold Vous êtes ici
- Passer du dataset Small au dataset Large
Dans les articles précédents, nous avons chargé nos données avec dbt seed, construit deux modèles Silver et ajouté des tests pour vérifier quelques règles essentielles.
Nous avons maintenant des données préparées et contrôlées. Il est temps de les utiliser pour répondre à une première question d'analyse.
Dans cet article, nous allons construire deux tables Gold :
- un catalogue qui réunit les informations des jeux et de leurs plateformes ;
- un résumé qui compte le nombre de jeux par plateforme.
La transformation SQL restera volontairement simple. Ce qui nous intéresse surtout, c'est la manière dont dbt relie les modèles entre eux.
Retrouver notre projet
Commençons par revenir dans le dossier du projet et réactiver l'environnement Python :
Set-Location "$env:USERPROFILE\Documents\dbt-retro-games"
.venv\Scripts\Activate.ps1
Avant d'ajouter la Gold, reconstruisons les modèles Silver et exécutons leurs tests :
dbt build --select path:models/silverCette sélection ne concerne que les modèles du dossier models/silver et les tests qui leur sont associés. Nos seeds existent déjà dans DuckDB depuis les articles précédents.
Créer le catalogue enrichi
Pour l'instant, silver_games contient le nom de la plateforme de chaque jeu, mais pas sa marque ni son nom court. Ces informations se trouvent dans silver_platforms.
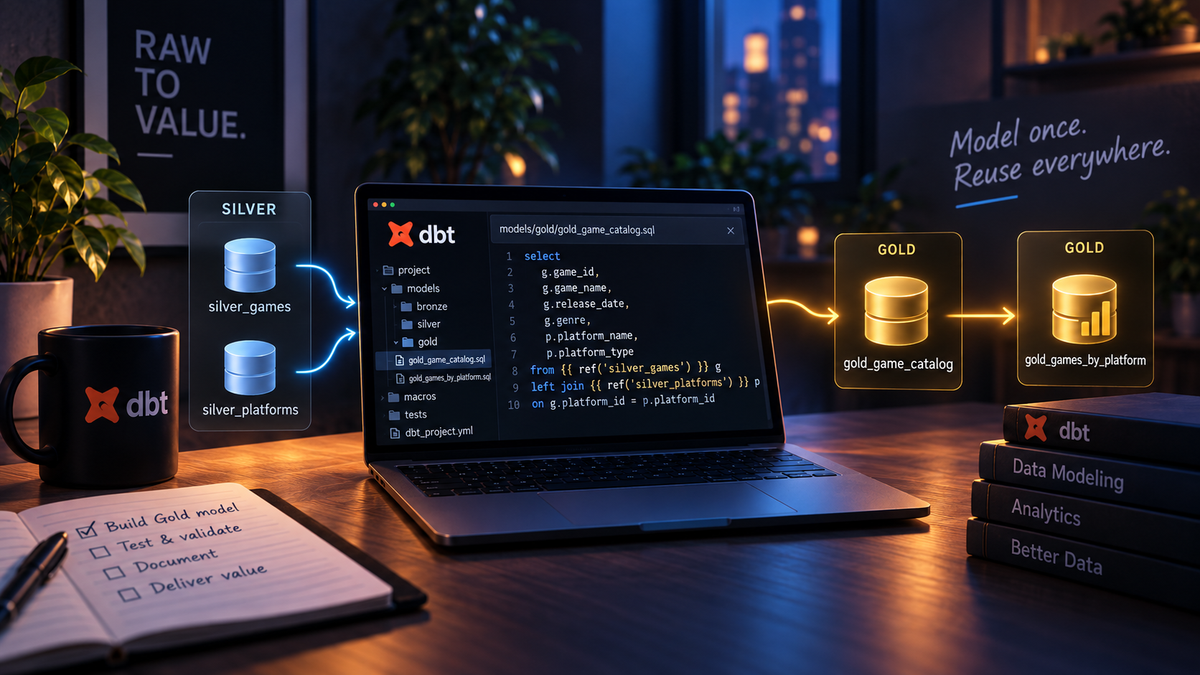
Créons le fichier models/gold/gold_game_catalog.sql :
select
    games.game_key,
    games.game_name,
    games.game_short_name,
    games.series_universe,
    games.release_date as game_release_date,
    platforms.platform_name,
    platforms.platform_short_name,
    platforms.brand,
    platforms.release_date as platform_release_date
from {{ ref('silver_games') }} as games
inner join {{ ref('silver_platforms') }} as platforms
    on games.platform_name = platforms.platform_name
La requête effectue une jointure SQL classique. La nouveauté se trouve encore dans les appels à ref().
Notre modèle Gold ne lit pas directement les seeds games et platforms. Il dépend des deux modèles Silver que nous avons préparés et testés.
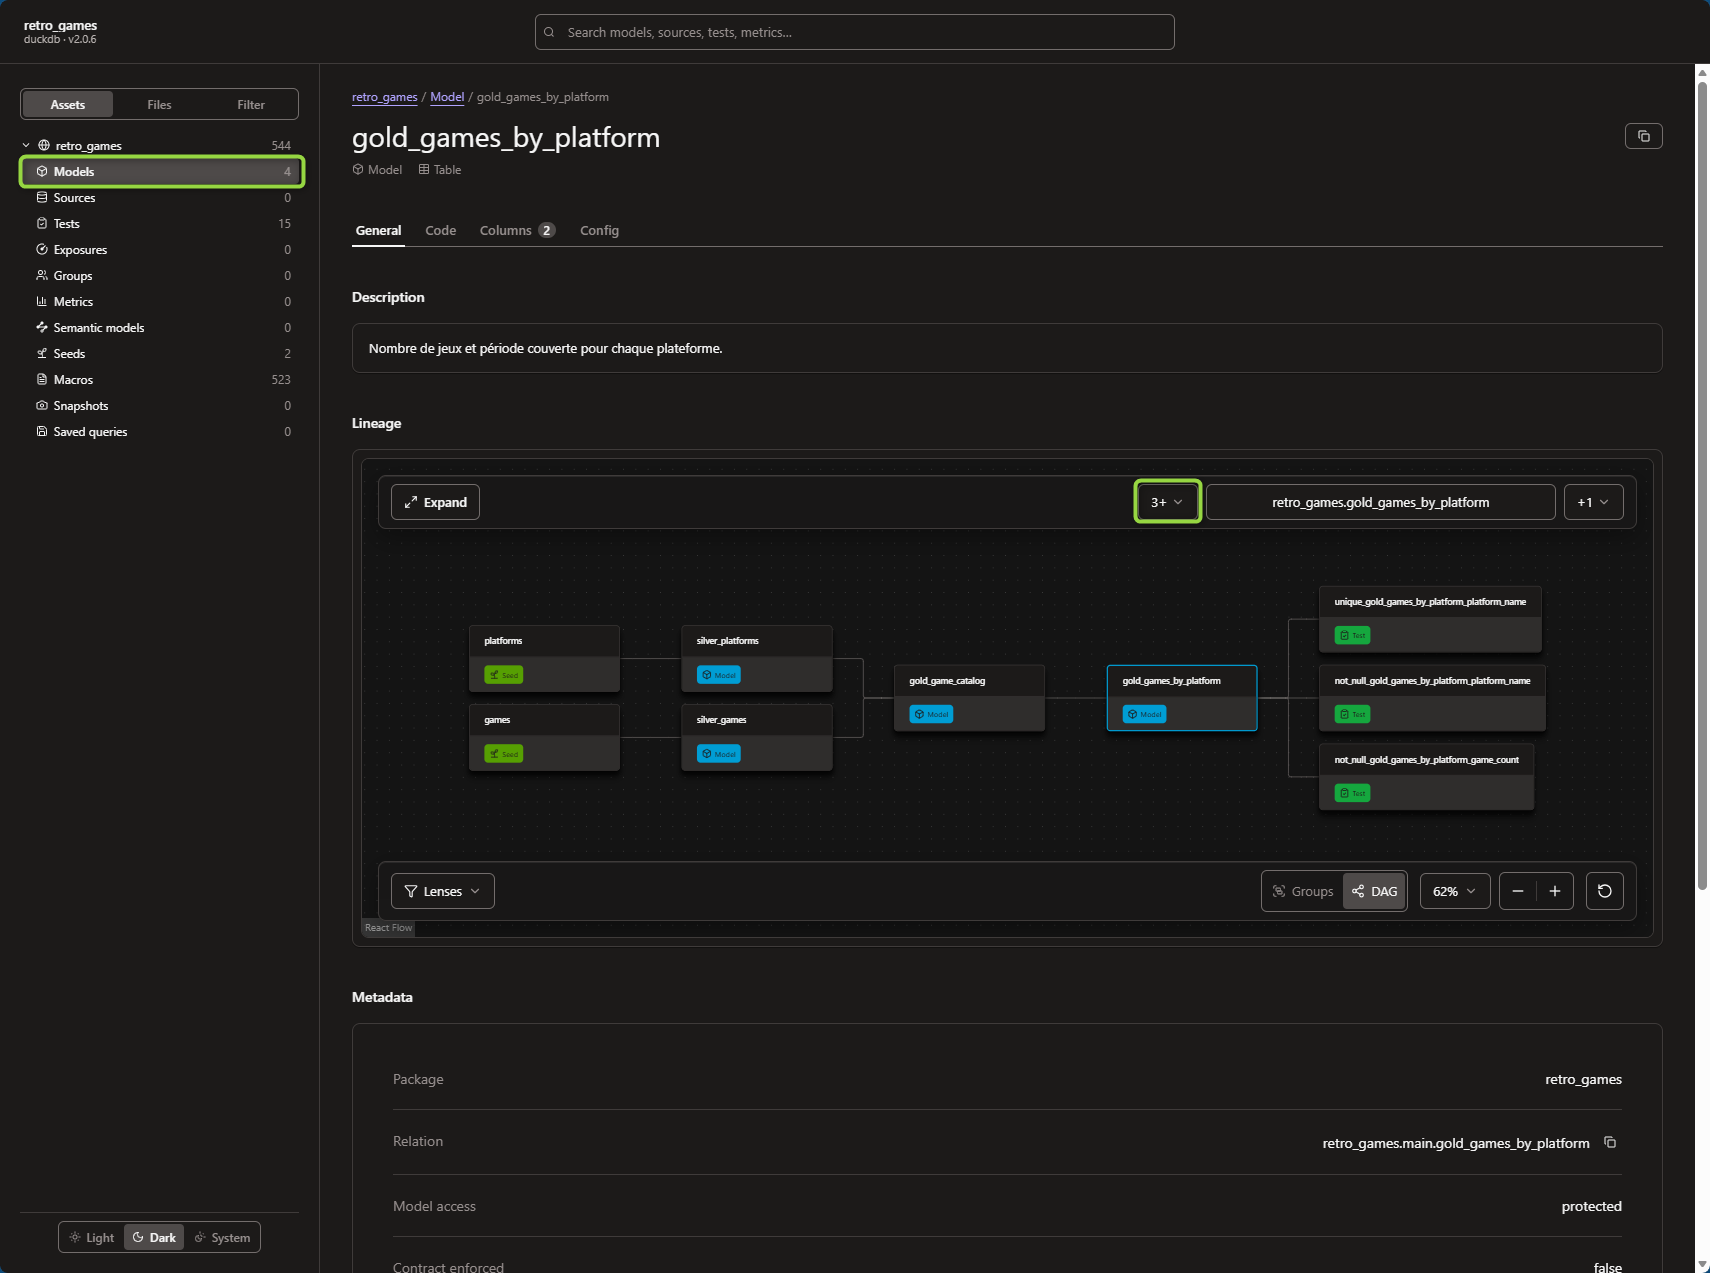
Notre graphe contient maintenant plusieurs niveaux :
games      → silver_games       ┐
                                ├→ gold_game_catalog
platforms  → silver_platforms   ┘
Construire le catalogue Gold
Exécutons uniquement le nouveau modèle :
dbt run --select gold_game_catalogdbt connaît ses dépendances grâce à ref(). Comme les tables Silver existent déjà, il crée le catalogue à partir de celles-ci.
Affichons quelques lignes :
dbt show --select gold_game_catalog --limit 5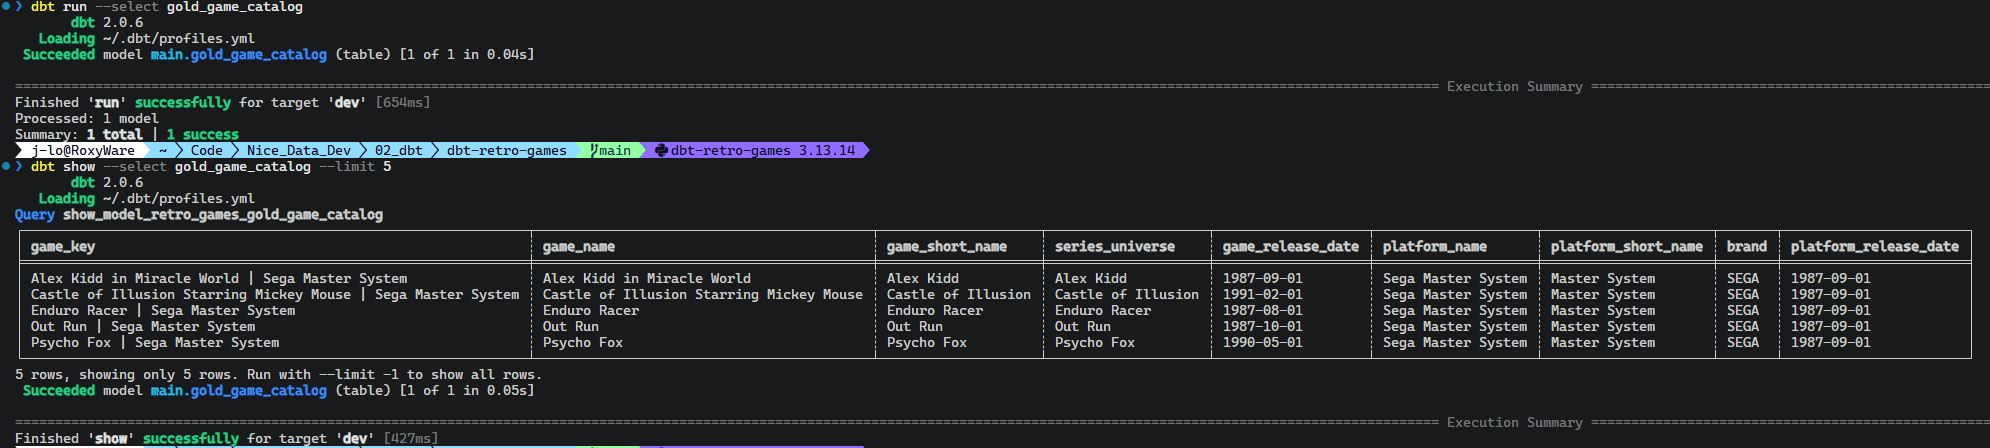
Nous avons toujours une ligne par jeu et par plateforme. La différence est que chaque ligne contient maintenant les informations utiles provenant de nos deux modèles Silver.
Compter les jeux par plateforme
Notre catalogue enrichi est déjà utile, mais nous pouvons maintenant répondre à une question simple : combien de jeux avons-nous pour chaque plateforme ?
Créons models/gold/gold_games_by_platform.sql :
select
    platform_name,
    platform_short_name,
    brand,
    count(*) as game_count,
    min(game_release_date) as first_game_release_date,
    max(game_release_date) as last_game_release_date
from {{ ref('gold_game_catalog') }}
group by
    platform_name,
    platform_short_name,
    brand
Cette fois, notre modèle dépend d'un autre modèle Gold. Il compte les jeux et conserve les premières et dernières dates de sortie présentes dans notre catalogue.
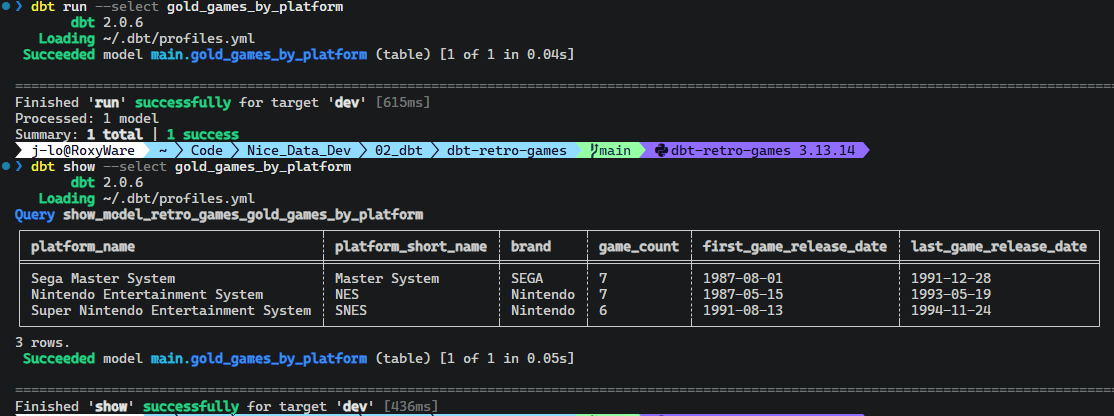
Lançons-le puis affichons son résultat :
dbt run --select gold_games_by_platform
dbt show --select gold_games_by_platform
Avec le dataset Small, nous devons obtenir :
Nintendo Entertainment System        7
Sega Master System                   7
Super Nintendo Entertainment System  6
L'ordre d'affichage peut différer, mais le total doit bien être de 20 jeux.
Tester les tables Gold
Comme pour nos modèles Silver, nous pouvons compléter les modèles Gold avec leurs descriptions et leurs tests.
Créons models/gold/gold.yml :
version: 2

models:
  - name: gold_game_catalog
    description: Catalogue des jeux enrichi avec les informations de leur plateforme.
    columns:
      - name: game_key
        description: Identifiant composé du jeu et de sa plateforme.
        data_tests:
          - not_null
          - unique

      - name: platform_name
        description: Plateforme associée au jeu.
        data_tests:
          - not_null

  - name: gold_games_by_platform
    description: Nombre de jeux et période couverte pour chaque plateforme.
    columns:
      - name: platform_name
        description: Nom officiel de la plateforme.
        data_tests:
          - not_null
          - unique

      - name: game_count
        description: Nombre de jeux présents pour la plateforme.
        data_tests:
          - not_null
Nous n'introduisons aucun nouveau type de test. Nous réutilisons simplement les règles que nous connaissons déjà.
Reconstruire toute la chaîne
Nous pouvons maintenant exécuter l'ensemble du projet avec une seule commande :
dbt builddbt suit le graphe des dépendances. Il charge les seeds, construit les modèles Silver, exécute leurs tests, construit les modèles Gold puis vérifie leurs règles.
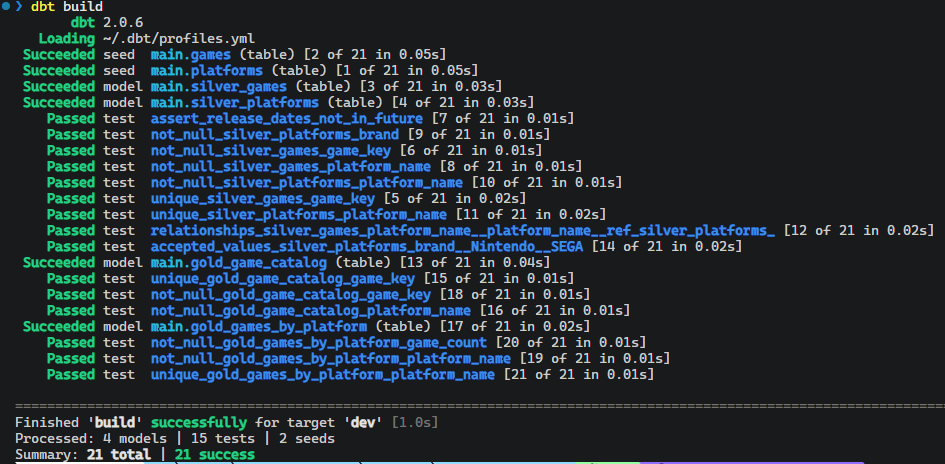
Nous n'avons écrit aucun script pour décrire manuellement cet ordre. Il existe déjà dans les appels à ref() et dans les tests associés aux ressources.
Observer le projet avec la documentation dbt
Nos fichiers YAML contiennent maintenant des descriptions et nos modèles forment un petit graphe. dbt peut générer une documentation à partir de ces informations :
dbt docs generate
dbt docs serve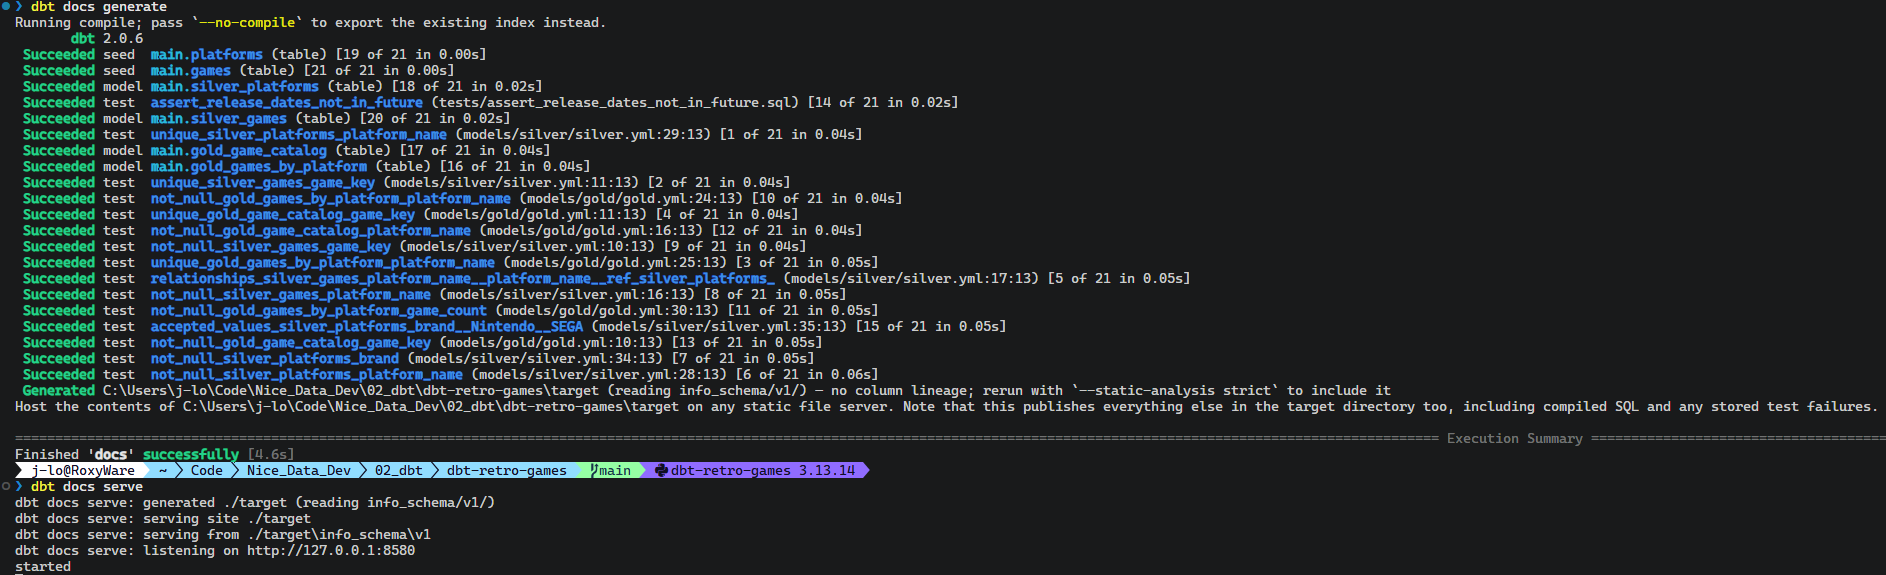
La seconde commande démarre un serveur local et ouvre normalement la documentation dans le navigateur. Nous pouvons sélectionner un modèle et afficher son lineage (en choisissant la profondeur pour voir la chaîne complète si besoin).
Lorsque nous avons terminé, Ctrl+C arrête le serveur dans PowerShell.
Nous n'allons pas explorer toute la documentation dbt dans cette série. Le graphe suffit déjà à rendre visible ce que ref() a construit au fil des articles.
Silver et Gold ne sont pas des règles universelles
Nous avons choisi les noms Silver et Gold parce qu'ils rendent notre progression facile à suivre et qu'ils sont assez courants dans les architectures Lakehouse, mais dbt n'impose pas ces dossiers et ne donne pas automatiquement une signification particulière à ces mots.
Dans un autre projet, nous pourrions rencontrer des dossiers staging, dwh et datamarts. L'idée reste la même : préparer les données progressivement et séparer les transformations techniques des modèles destinés à l'analyse.
En résumé
Nous avons joint nos deux modèles Silver dans gold_game_catalog, puis créé gold_games_by_platform pour répondre à une première question d'analyse.
Grâce aux appels à ref(), dbt connaît maintenant toute la chaîne allant des seeds aux tables Gold. Nous avons également généré la documentation du projet et observé le graphe correspondant.
Notre projet fonctionne avec 20 jeux. Dans le prochain article, nous allons remplacer le dataset Small par sa version Large et vérifier si toute cette logique continue de fonctionner sans réécrire les modèles.
Ressources officielles
- Générer et consulter la documentation dbt — utiliser
dbt docs generateetdbt docs serve. - Comprendre la fonction ref() — suivre les dépendances entre les modèles Silver et Gold.