
Data Engineering
dbt : passer du dataset Small au dataset Large
Remplacez le dataset Small par 340 jeux, rejouez toute la chaîne dbt et vérifiez que vos modèles et vos tests tiennent sans réécrire le SQL.
Data Engineering
Remplacez le dataset Small par 340 jeux, rejouez toute la chaîne dbt et vérifiez que vos modèles et vos tests tiennent sans réécrire le SQL.
Architecture Data
Construisez deux modèles Gold avec dbt, reliez-les aux modèles Silver avec ref(), ajoutez des tests et visualisez le graphe de dépendances du projet.

Plateformes Data
Déclenchons un notebook Fabric paramétré avec run() pour télécharger un fichier depuis GitHub et le déposer dans un Lakehouse.

Plateformes Data
Centralisons les constantes et fonctions partagées dans un notebook Fabric commun puis réutilisons-les avec %run sans copier-coller.
Développement
Ajoutez des tests dbt à vos modèles Silver, provoquez un échec contrôlé et écrivez un test SQL personnalisé pour fiabiliser la qualité des données.
Data Engineering
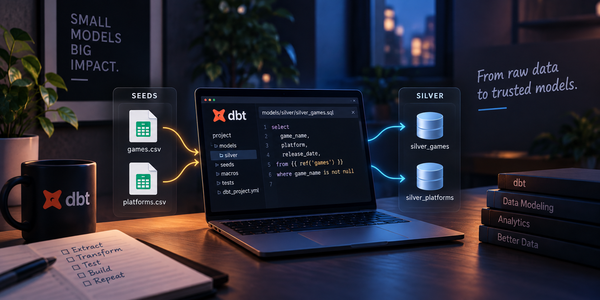
Construisez vos premiers modèles Silver avec dbt et DuckDB, découvrez ref(), les dépendances et les matérialisations, puis interrogez le résultat en SQL.
Développement
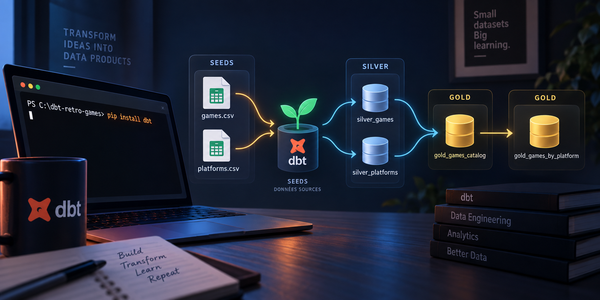
Installez dbt v2 avec DuckDB sous Windows, créez un premier projet local et chargez deux fichiers CSV avec dbt seed pour préparer la suite de la série.

IA appliquée
Après l’effet waouh du code généré par l’IA, j’ai découvert une nouvelle dette technique : celle des décisions que je n’avais pas comprises. Retour d’expérience sur une façon de construire plus vite sans abandonner l’architecture.
Dans le monde de l'ingénierie des données moderne, Databricks est un nom très connu. Lorsque l'on gravite autour de Spark, on utilise très régulièrement des outils ou concept directement issue de Databricks. Dans cet article nous allons faire nos premiers pas directement sur la plateforme Databricks
Il y a quelque temps, Microsoft a annoncé un type de job particulier, les "Copy job". Dans de nombreux projets, pour des raisons d'impact sur les bases opérationnelles, nous faisons des copies des données sources pour travailler de façon autonome par la suite. Ce type de job est justement là pour tr
Microsoft a annoncé très récemment la "Public Preview" d'un provider Terraform pour Microsoft Fabric. Nous allons ici tester les basics de la mise en place d'une Infrastructure as Code (IaC) autour de Fabric !

Après avoir alimenté notre zone bronze : Paramétrer les Pipeline Azure Synapse Analytics sans ouvrir Synapse ! ; Après avoir alimenté notre zone sliver : Notre premier notebook Spark dans Synapse ; Nous allons maintenant alimenter notre zone gold et créer notre pipeline d'intégration complet de l'ingestion de nos données On-