dbt : construire nos premiers modèles Silver
Construisez vos premiers modèles Silver avec dbt et DuckDB, découvrez ref(), les dépendances et les matérialisations, puis interrogez le résultat en SQL.

Découvrir dbt avec un projet simple
- Installer dbt et créer nos premières tables
- Construire nos premiers modèles Silver Vous êtes ici
- Tester la qualité de nos données
- Construire notre première zone Gold
- Passer du dataset Small au dataset Large
Dans le premier article, nous avons installé dbt et utilisé dbt seed pour charger games.csv et platforms.csv dans une base DuckDB locale.
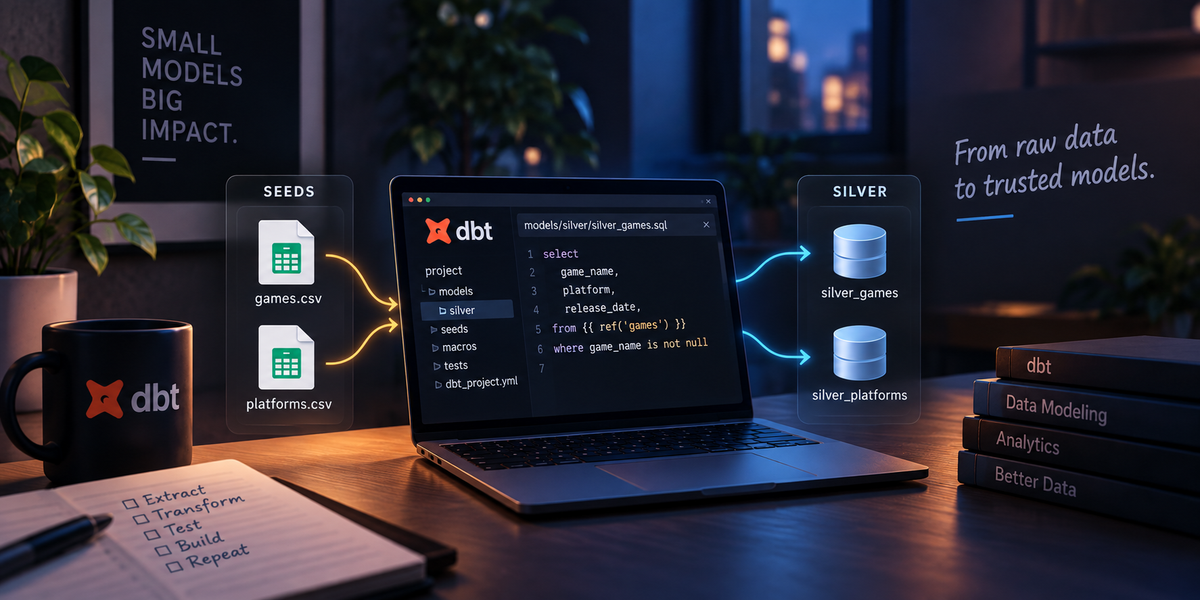
Nous avons maintenant deux tables, mais elles correspondent encore directement aux fichiers sources. Nous allons enfin créer une couche Silver avec des noms de colonnes plus explicites, des dates correctement typées et une clé qui identifie chaque jeu sur sa plateforme.
C'est à partir de cet article que dbt commence réellement son travail de transformation.
Réactiver l'environnement du projet
Un environnement virtuel Python n'est actif que dans le terminal où nous l'avons lancé. Si nous avons fermé PowerShell depuis le premier article, revenons dans le projet et réactivons-le :
Set-Location "$env:USERPROFILE\Documents\dbt-retro-games"
.venv\Scripts\Activate.ps1
Nous pouvons vérifier que les seeds sont toujours connus de dbt :
dbt show --select games --limit 3La base DuckDB a bien été conservée dans retro_games.duckdb. Il n'est donc pas nécessaire de relancer dbt seed à chaque ouverture du terminal.
Pourquoi une couche Silver ?
Dans cet exemple, les colonnes des CSV sont déjà plutôt propres. Nous pourrions les utiliser directement, mais notre objectif est de séparer les données reçues des données préparées pour les analyses et de comprendre la logique dbt, pas de rentrer dans des scripts de transformation complexes.
Dans cette série :
- les seeds représentent notre point d'entrée, proche d'une zone Bronze ;
- les modèles Silver rendent les données cohérentes et explicites ;
- les futurs modèles Gold répondront à un besoin d'analyse.
Pour un dataset de 20 lignes, cette séparation peut sembler très poussée et un peu superflue. Cependant, elle nous permet surtout de comprendre le rôle de chaque modèle avant de travailler sur un projet plus important.
Créer le modèle silver_platforms
Dans models/silver, créons un fichier silver_platforms.sql :
select
    official_name as platform_name,
    short_name as platform_short_name,
    brand,
    cast(release_date as date) as release_date
from {{ ref('platforms') }}
Ce fichier contient une requête select très classique avec cependant un élément inhabituel :
{{ ref('platforms') }}ref() indique à dbt que notre modèle dépend de la ressource platforms. Nous faisons ici référence à une ressource dbt ; nous allons revenir juste après sur ce mécanisme.
Nous renommons aussi les deux premières colonnes. official_name devient platform_name et short_name devient platform_short_name. Ce n'est pas obligatoire, mais ces noms seront plus faciles à comprendre lorsque nous joindrons plusieurs tables.
Enfin, nous convertissons release_date en véritable date. Dans un CSV, les valeurs arrivent comme du texte. Notre modèle Silver précise le type que nous voulons utiliser ensuite.
Créer le modèle silver_games
Dans le même dossier, créons silver_games.sql :
select
    concat_ws(' | ', official_name, platform_official_name) as game_key,
    official_name as game_name,
    short_name as game_short_name,
    platform_official_name as platform_name,
    cast(release_date as date) as release_date,
    series_universe
from {{ ref('games') }}
La transformation reste volontairement courte. Nous renommons les colonnes, convertissons la date et créons une nouvelle colonne game_key.
Cette clé combine le nom officiel du jeu et celui de sa plateforme. Pour notre version Small, le nom du jeu suffirait presque. Mais un même titre peut exister sur plusieurs plateformes dans un dataset plus complet. En intégrant la plateforme, nous décrivons mieux ce que représente une ligne.
Comprendre ref()
Nous venons d’utiliser ref() dans nos deux modèles. Comme prévu, arrêtons-nous un instant dessus : c’est l’un des mécanismes les plus importants de dbt.
Dans silver_platforms.sql, nous avons écrit :
from {{ ref('platforms') }}ref() permet de référencer une autre ressource du projet par son nom logique, plutôt que d’écrire directement le nom physique de la table dans la base.
Ici, le fichier seeds/platforms.csv devient une ressource dbt nommée platforms.
Pour un modèle SQL, le principe est similaire. Le fichier models/silver/silver_platforms.sql définit un modèle nommé silver_platforms. Un autre modèle pourra donc plus tard le référencer avec :
{{ ref('silver_platforms') }}ref() apporte deux choses importantes à dbt :
- il permet à dbt de retrouver la bonne relation dans la base ;
- il déclare une dépendance entre les ressources.
Dans notre cas :
platforms → silver_platforms
games     → silver_games
dbt peut ainsi déterminer l’ordre d’exécution sans que nous ayons à écrire nous-mêmes un script d’orchestration. À partir des appels à ref(), il construit le graphe de dépendances du projet.
Exécuter les modèles Silver
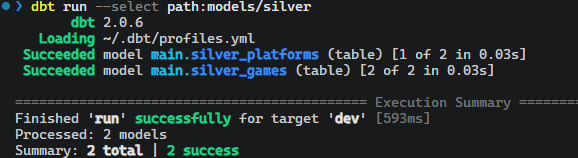
Depuis PowerShell, lançons uniquement les modèles présents dans le dossier Silver :
dbt run --select path:models/silverdbt commence par analyser le projet. Il comprend que silver_games dépend de games et que silver_platforms dépend de platforms, puis il crée les deux nouvelles tables.
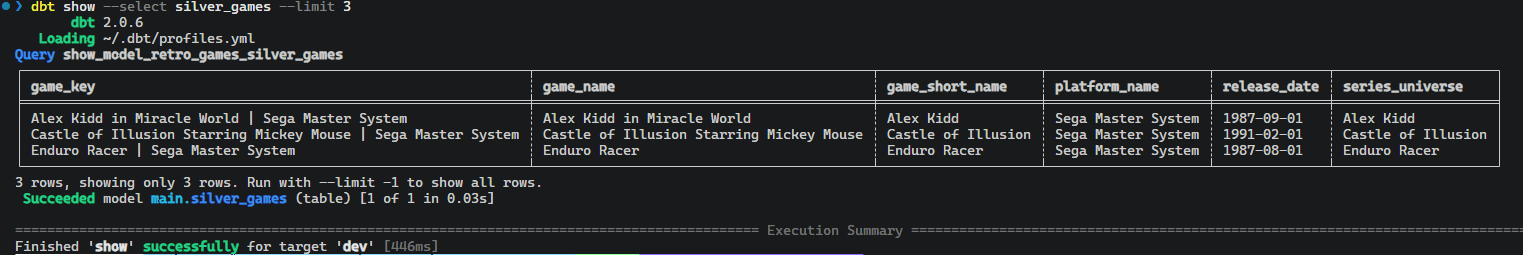
Affichons quelques jeux transformés directement depuis notre nouvelle table :
dbt show --select silver_games --limit 3Nous retrouvons game_key, les nouveaux noms de colonnes et une date reconnue comme telle.
Un fichier SQL devient un modèle dbt
Dans dbt, chaque fichier SQL du dossier models représente un modèle. Le nom du fichier devient le nom du modèle dbt. Avec notre configuration actuelle, ce modèle est matérialisé sous forme de table portant ce nom.
Notre fichier ne contient pas de commande create table. Nous écrivons seulement la requête qui décrit le résultat attendu. dbt se charge de construire la table, de la remplacer lorsque le modèle change et d'exécuter les modèles dans le bon ordre.
C'est une différence importante avec un script SQL composé d'une longue suite de créations et de suppressions de tables. Chaque modèle reste centré sur une seule transformation.
Le graphe commence à se construire
Grâce aux appels à ref(), dbt connaît déjà les premières dépendances de notre projet :
games      → silver_games
platforms  → silver_platforms
Pour l’instant, les deux modèles Silver sont indépendants l’un de l’autre. Mais dans la future zone Gold, certains modèles dépendront à leur tour de silver_games et silver_platforms.
Le graphe deviendra alors plus intéressant, et dbt utilisera toujours les mêmes références pour déterminer l’ordre d’exécution.
Tables ou vues ?
Dans dbt_project.yml, nous avons choisi cette configuration :
models:
  retro_games:
    +materialized: table
Elle demande à dbt de créer tous nos modèles sous forme de tables. dbt sait aussi créer des vues, des modèles incrémentaux ou des modèles éphémères.
Nous n'allons pas voir ces possibilités maintenant. Une table est simple à observer et convient très bien pour un premier projet. Le point important est que la requête du modèle reste la même : la matérialisation indique seulement comment dbt conserve son résultat dans la base.
Exécuter un modèle précis
Lorsque nous travaillons sur un seul fichier, nous pouvons demander à dbt de ne reconstruire que celui-ci :
dbt run --select silver_gamesCette sélection devient pratique quand un projet contient de nombreux modèles. Pour notre exemple, exécuter les deux tables Silver reste évidemment très rapide.
En résumé
Nous avons créé nos deux premiers modèles dbt. silver_games prépare les jeux, tandis que silver_platforms prépare les plateformes.
ref() relie les modèles à leurs données d'origine et permet à dbt de comprendre leurs dépendances. Nous avons aussi découvert qu'un modèle contient principalement la requête décrivant son résultat : dbt s'occupe de créer la table autour.
Nos tables Silver semblent correctes lorsque nous affichons quelques lignes. Dans le prochain article, nous allons arrêter de nous contenter de cette impression et définir des règles que dbt pourra vérifier automatiquement.
Pour aller un peu plus loin
dbt n’enferme pas les données dans un format propriétaire ; il produit ici de vraies tables DuckDB interrogeables avec du SQL classique.
Si la commande duckdb n’est pas disponible, vous pouvez installer la CLI dans votre environnement virtuel :
pip install duckdb-cliNous pouvons ensuite ouvrir directement la base :
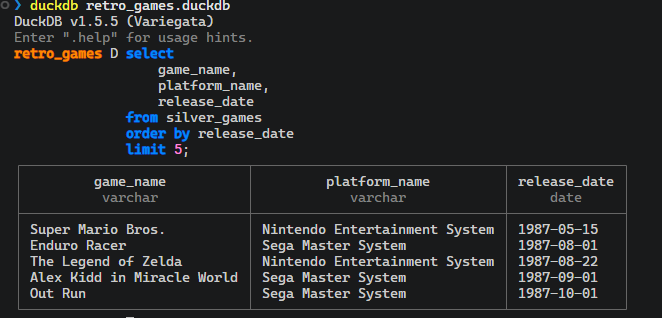
duckdb retro_games.duckdbPuis exécuter une requête SQL classique :
select
    game_name,
    platform_name,
    release_date
from silver_games
order by release_date
limit 5;
Nous retrouvons ici la table silver_games créée par dbt.
dbt nous aide à définir, organiser et exécuter les transformations, mais le résultat reste constitué de tables classiques dans notre base de données.
Ressources officielles
- Comprendre la fonction ref() — référencer une ressource et déclarer les dépendances du projet.
- Comprendre les matérialisations — choisir comment dbt construit et conserve le résultat d’un modèle.